







เมื่อ GPU ปรับขนาด เครือข่ายจะตัดสินใจผลลัพธ์
AI กำลังเข้าสู่ยุคที่คลัสเตอร์เติบโตเร็วกว่าที่ใครๆ คาดคิด GPU นับพันกลายเป็นหมื่น และขั้นตอนต่อไปก็เพิ่มมากขึ้น แต่หลายทีมค้นพบความจริงที่น่าอึดอัดใจ นั่นคือ การเพิ่มการประมวลผลไม่ได้เพิ่มประสิทธิภาพเสมอไป เมื่อโมเดลมีขนาดใหญ่ขึ้น ค่าใช้จ่ายในการสื่อสารก็เพิ่มขึ้น การซิงโครไนซ์ก็จะหนักขึ้น และเครือข่ายก็กลายเป็นคอขวดแบบเงียบๆ
นี่คือที่มาของกฎใหม่ ในการฝึกอบรม AI ยุคใหม่ เพดานที่แท้จริงมักไม่ใช่ตัวเร่งความเร็ว-แต่เป็นโครงสร้าง หากการเชื่อมต่อระหว่างกันของคุณไม่สามารถก้าวทันได้ คุณจะต้องจ่ายค่าประมวลผลราคาแพงที่รอ ไม่ได้ใช้งาน และเปลืองพลังงานโดยไม่ให้ผลลัพธ์

เหตุใด AI Fabrics จึงต้องการการก้าวกระโดดแบบออปติคอลระดับ 1.6T-
AI Fabric ถูกสร้างขึ้นเพื่อภารกิจเดียว นั่นคือ ขับเคลื่อนข้อมูลในวงกว้าง อย่างไรก็ตาม การเชื่อมต่อระหว่างกันแบบดั้งเดิมไม่ได้ออกแบบมาเพื่อความเข้มข้นของการสื่อสารของการฝึกอบรมแบบกระจายจำนวนมาก ความแออัด เวลาแฝงที่สูงขึ้นภายใต้ภาระงาน และแรงเสียดทานของขนาดจะปรากฏขึ้นในเวลาที่คุณต้องการความเสถียรมากที่สุด
เลเยอร์ออปติคัล 1.6T ไม่ใช่การอัพเกรดเพื่อประโยชน์ของตัวเลข แต่เป็นการตอบสนองเชิงปฏิบัติต่อความเป็นจริงของ AI ในปัจจุบัน: การรับส่งข้อมูลตะวันออก-ตะวันตกที่สูงขึ้น การสลับที่หนาแน่นขึ้น และขอบเขตอำนาจที่เข้มงวดยิ่งขึ้น เมื่อแบนด์วิธแฟบริคของคุณเพิ่มขึ้น คลัสเตอร์จะมีการประมวลผลมากขึ้นและรอน้อยลง
การก้าวกระโดดครั้งนี้ยังช่วยให้มีช่องว่างสำหรับการสร้างสรรค์นวัตกรรมอีกด้วย วิศวกรสามารถสำรวจกลยุทธ์การขนานใหม่ๆ ทดลองกับขนาดแบทช์ที่ใหญ่ขึ้น และสร้างโมเดลที่ซับซ้อนมากขึ้นได้ เนื่องจากเครือข่ายไม่ใช่จุดอ่อนที่สุดอีกต่อไป คลาส 1.6T ช่วยให้นักพัฒนามุ่งเน้นไปที่การพัฒนาอัลกอริทึมมากกว่าข้อจำกัดของเครือข่าย

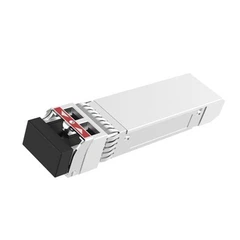
1.6T OSFP-XD DR8+: สร้างขึ้นเพื่อการเชื่อมต่อระหว่างกันของ AI ที่หนาแน่นและสั้น-
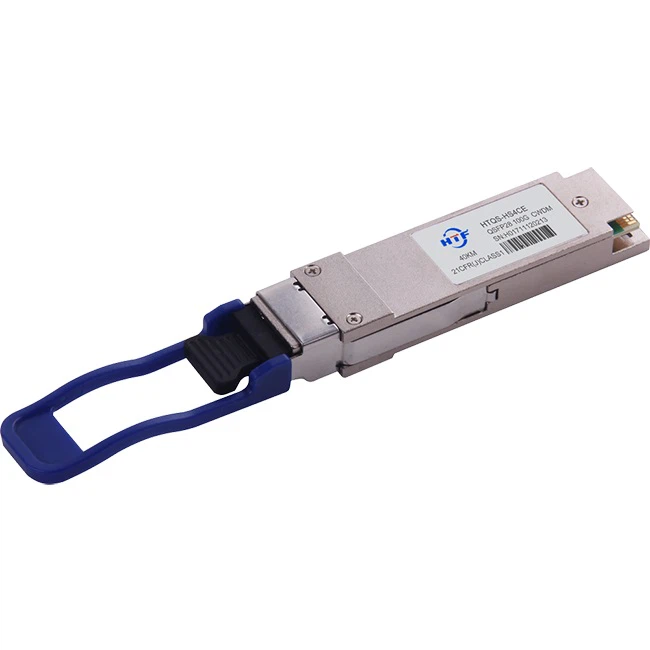
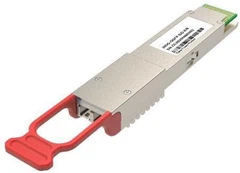
ตัวรับส่งสัญญาณ 1.6T OSFP-XD DR8+ ได้รับการออกแบบมาเพื่อส่งผ่านข้อมูลรวม 1600G บนไฟเบอร์โหมดเดี่ยว- พร้อมการปรับ PAM4 ซึ่งได้รับการออกแบบมาเพื่อรองรับคลื่นลูกใหม่ของเครือข่าย AI ฟอร์มแฟคเตอร์ OSFP-XD ช่วยให้พอร์ตมีความหนาแน่นสูง ในขณะที่สถาปัตยกรรม DR8 สอดคล้องกับโครงสร้างลีฟสไปน์สมัยใหม่อย่างเป็นธรรมชาติ ซึ่งมีลิงก์-การเข้าถึงที่สั้นและมีปริมาณงานสูง-เป็นสำคัญ
ที่สำคัญกว่านั้นคือการรักษาสมดุลระหว่างประสิทธิภาพกับความเป็นจริงในการปฏิบัติงาน ศูนย์ข้อมูล AI ให้ความสำคัญกับเฮดรูมระบายความร้อน การกระจายพลังงาน และความเสถียรของระบบ ไม่ใช่แค่อัตราไลน์เท่านั้น ด้วยการกระจายพลังงานที่ต่ำกว่า 25 W โมดูลจึงอยู่ในตำแหน่งเพื่อรองรับขนาด โดยไม่ต้องบังคับให้ต้องออกแบบกลยุทธ์การทำความเย็นใหม่
การปฏิบัติตามข้อกำหนดของโมดูลกับ IEEE 802.3df และความสอดคล้องกับข้อตกลงหลายแหล่งที่มาของ OSFP-XD ช่วยให้มั่นใจได้ถึงความสามารถในการทำงานร่วมกัน สามารถเสียบปลั๊กได้ทันทีและรองรับอินเทอร์เฟซการจัดการมาตรฐาน ทำให้การปรับใช้ตรงไปตรงมา
จาก "แบนด์วิธดิบ" สู่ "ประสิทธิภาพของคลัสเตอร์ที่ใช้งานได้"
ในโครงสร้างพื้นฐาน AI ความแตกต่างระหว่างแบนด์วิดท์ทางทฤษฎีและประสิทธิภาพที่แท้จริงคือทุกสิ่ง Fabric สามารถดูได้รวดเร็วบนกระดาษ แต่ยังคงชะลอการฝึกอบรมด้วยความล่าช้าในการซิงโครไนซ์ รูปแบบการรับส่งข้อมูลที่ไม่สม่ำเสมอ และความเจ็บปวดจากการสมัครสมาชิกมากเกินไป การเชื่อมต่อแบบออปติคัลที่เหมาะสมช่วยให้คุณกู้คืนประสิทธิภาพที่สูญเสียไป
ด้วยลิงก์ 1.6T คุณสามารถเพิ่มความจุเครือข่ายต่อพอร์ต ลดความซับซ้อนในการวางแผนโทโพโลยี และลดแรงกดดันต่อจำนวนสายเคเบิลและชั้นการรวมตัว เป็นผลให้แฟบริคกลายเป็นตัวกระตุ้นประสิทธิภาพแทนที่จะเป็นข้อจำกัดคงที่ การลดความยาวของสายเคเบิลยังส่งผลให้การบำรุงรักษาง่ายขึ้นและลดความเสี่ยงที่จะเกิดข้อผิดพลาดระหว่างการอัพเกรด
ออกแบบมาสำหรับผู้ประกอบการที่ปรับขนาด AI เพื่อหาเลี้ยงชีพ
ศูนย์ข้อมูล AI ไม่เพียงแต่ใหญ่กว่า - เท่านั้น แต่ยังมีความละเอียดอ่อนมากกว่าอีกด้วย ผู้ปฏิบัติงานต้องรับมือกับการเติบโตมหาศาล ในขณะเดียวกันก็รักษาเวลาทำงาน ความสามารถในการให้บริการ และต้นทุนด้านพลังงานไว้ภายใต้การควบคุม นั่นคือเหตุผลที่ 1.6T OSFP-XD DR8+ มุ่งเน้นไปที่ข้อกำหนดการใช้งานจริง: การออกแบบที่เสียบปลั๊กได้ อินเทอร์เฟซการจัดการที่เป็นมาตรฐาน (I2C) และ-ศูนย์-ช่วงอุณหภูมิการทำงานที่เป็นมิตรต่อข้อมูล
เมื่อคลัสเตอร์ของคุณขยายตัว คุณจะต้องมีโครงสร้างพื้นฐานที่ปรับขนาดได้อย่างราบรื่น คุณต้องมีออปติคัลที่ทำให้แฟบริคสามารถคาดการณ์ได้ บำรุงรักษาได้ และสม่ำเสมอ - โดยเฉพาะอย่างยิ่งในระหว่างการอัปเกรดและการขยายกำลังการผลิต วิธีการแบบโมดูลาร์ช่วยลดเวลาหยุดทำงานและให้ความมั่นใจแก่ผู้ปฏิบัติงานในการเปิดตัวกำลังการผลิตใหม่โดยไม่รบกวนปริมาณงานที่กำลังดำเนินอยู่
ที่ไหนเหมาะที่สุด
โมดูลนี้เหมาะอย่างยิ่งสำหรับแฟบริคการฝึกอบรม AI คลัสเตอร์การอนุมานขนาดใหญ่- และสภาพแวดล้อมการสลับสเกลระดับไฮเปอร์สเกลที่ต้องการความหนาแน่นสูงและการเปิดตัวที่รวดเร็ว รองรับเลเยอร์การเชื่อมต่อแบบออปติคอล-การเข้าถึงระยะสั้นซึ่งการรับส่งข้อมูล AI ส่วนใหญ่ไหลผ่าน การเชื่อมต่อสวิตช์ความเร็วสูง- และโหนดประมวลผลข้ามแร็ค แถว หรือส่วนห้องข้อมูล
เมื่อเป้าหมายของคุณคือการเร่งเวลา-ในการฝึก-และคงการใช้งานให้สูง เลเยอร์ออปติคัลจะต้องก้าวหน้าเท่ากับเลเยอร์การประมวลผล นั่นคือหน้าที่ที่ 1.6T ตั้งใจจะเล่น

ประเด็นสำคัญ: สร้างเครือข่าย AI ที่ไม่หยุดยั้งการประมวลผล AI
การลงทุนของ AI วัดกันที่ GPU แต่ความสำเร็จของ AI วัดกันที่ปริมาณงาน ความเสถียร และความเร็วในการทำซ้ำ หากแฟบริคกลายเป็นคอขวด คลัสเตอร์ทั้งหมดจะสูญเสียคุณค่า 1.6T OSFP-XD DR8+ ได้รับการออกแบบมาเพื่อขจัดปัญหาคอขวดนั้น และช่วยให้โครงสร้างพื้นฐาน AI ของคุณขยายขนาดได้อย่างมั่นใจ
เมื่อคุณเปลี่ยนไปใช้ 1.6T คุณไม่ได้เพียงแค่ซื้อโมดูลที่เร็วขึ้นเท่านั้น คุณกำลังซื้อผ้าที่สอดคล้องกับความทะเยอทะยานของคุณ - เพื่อให้ GPU ของคุณสามารถใช้เวลาฝึกฝนมากขึ้นและใช้เวลารอน้อยลง การลงทุนในเลเยอร์ออปติคัลแบบมองไปข้างหน้า-ในวันนี้ จะทำให้คุณวางตำแหน่งตัวเองเพื่อปรับใช้สถาปัตยกรรมโมเดลแห่งอนาคตโดยไม่ลังเลใจ